重點摘要
你的耳朵能抓到偷懶的 AI 歌——糊成一片的銅鈸、押韻卻什麼都沒說的歌詞、從來不換氣的嗓音——但用當前模型、提示詞寫得好的歌,隨便聽聽是能矇混過關的。凡是要緊的場合(授權、歌單投稿、比賽、購買),都應該過一遍偵測器。Suno AI Music 上的 AI 音樂偵測接受連結或檔案,去聽每個主流生成器留下的痕跡,回傳一個機率,以及這首歌最像哪個生成器。我們用一首自己在 Suno 上生成的歌測了一下——98% AI,最接近 Suno——又測了 Rick Astley 的 Never Gonna Give You Up——0%,最接近 Human(真人)。偵測一次 20 點數。
本文目錄
為什麼這件事變難了
兩年前破綻很明顯:金屬味的人聲、到第二段主歌就散掉的歌詞、晃了三分鐘都沒有副歌的歌。現在的模型——Suno v6、Udio、ElevenLabs Music、Google 的 Lyria——會寫主歌-副歌結構,能讓一首歌從頭到尾維持同一個嗓音,還能把母帶做到串流平台的響度。把一首做得好的放給朋友聽而不告訴他,他多半不會察覺。
所以問題已經從「它聽起來假不假?」變成了「我手上有什麼證據?」。你的耳朵能給你一些。情境能給你更多。偵測器則給你一個可以據此行動的數字。
該聽什麼
下面沒有一條能單獨證明什麼,而且每一條在真人製作的歌裡也可能出現。但當三四條疊在一起時,就該往 AI 那邊傾斜了。
糊成一片的高頻
戴好耳機聽銅鈸、Hi-hat 和人聲裡的「s」音。生成的音訊常常把它們做成一片嘶嘶的霧,而不是一下一下清楚的敲擊,在密集的副歌裡尤其明顯。這是最可靠的一項耳朵測試,也是模型最難修的一項,因為它來自音訊的合成方式本身。
從不換氣的嗓音
真人歌手要換氣,混音師通常也會留下一些換氣聲。很多 AI 人聲一句接一句,完全沒有吸氣,或有一口聽起來像是貼上去的氣。也聽聽子音:一個字開頭很乾淨、結尾卻含糊成一團,是常見的痕跡。
押韻卻什麼都沒說的歌詞
AI 歌詞往往泛泛地煽情——霓虹燈、午夜的夢、靈魂裡的火——韻腳完美,卻沒有任何具體細節。真人寫詞會寫出一條街名、一個年份、一個人。如果你能把兩首歌的主歌對調而沒人發現,這就是一條線索。
結構太整齊,或結尾很怪
這些歌常常每個段落的分界都剛好卡在小節線上,能量曲線像套了模板。結尾是另一個破綻:在一句話中間開始的淡出,或因為模型到了長度上限而突然冒出來的最後一個和弦。
樂器換了身分
從頭到尾只聽一件樂器。一把吉他的音色在主歌和副歌之間悄悄變形,或一台鋼琴變成了另一台略有不同的鋼琴,這是生成出來的典型特徵,而不是錄出來的。
音訊之外的線索
很多時候最快的答案根本不在波形裡:
- 藝人沒有任何過往。 一個三個月發了四十首歌、沒有任何現場演出、除了一張氛圍照之外沒有別的照片、也沒有社群存在感的帳號,這個模式值得留意。
- 沒有署名。 正規發行會列出詞曲作者和製作人。一首在哪裡都找不到詞曲作者署名的歌,是一個警訊。
- 作品曲風寬得可疑。 週一 lo-fi,週三鄉村,週五 drill——全出自同一個「藝人」。
- 這首歌辨識不出來。 一首聽起來很流行、聽歌識曲卻從沒聽過的歌,要嘛是新歌、未發行的歌、版權庫音樂——要嘛就是生成的。我們的不知道歌名怎麼找歌指南解釋了沒找到通常代表什麼。
怎麼用偵測器檢查一首歌
這個偵測器是一個音訊模型,用各大生成器——Suno、Udio、Mureka、ElevenLabs 等——的輸出訓練而成。它去聽每一家留下的痕跡:瞬態是怎麼糊的、立體聲寬度怎麼表現、人聲在混音裡怎麼擺。
- 打開 AI 音樂偵測並登入。同一個工具也在 AI 歌曲核查、AI 音樂核查、AI 歌曲檢測和這首歌是 AI 嗎?這幾個頁面上——用哪個都行,結論都一樣。
- 選擇怎麼把歌送進去:
- 貼上連結——YouTube、TikTok、Instagram、X、Vimeo 或 Facebook。音訊會幫你抓取。
- 上傳——MP3、WAV、M4A,或 MP4 裡的音訊,最大 10 MB。三十秒就夠了;你不需要整首歌。
- 按檢測這首歌(20 點數)。
- 看結論、機率、最接近的生成器,以及各家生成器的分數。
如果偵測跑不起來——檔案讀不了、網頁載入不出來——20 點數會馬上退回。
我們的測試 兩首歌兩個結論
我們想要一個乾淨的對照,所以給偵測器餵了一首確定是 AI 的歌,和一首確定不是的。
第一首是一首帶女聲的 tech house,是我們自己在 Suno 上為網站的範例畫廊生成的。我們把生成器產出的 MP3 原封不動上傳:
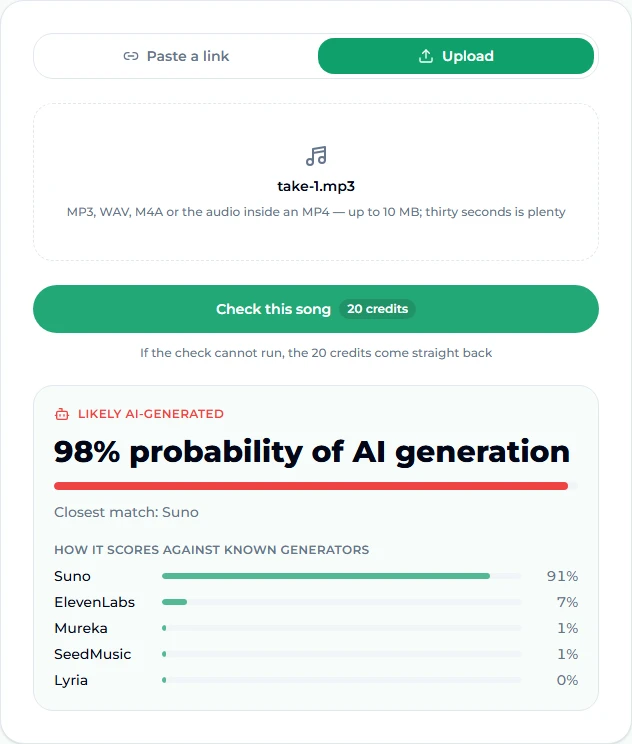
AI 生成的機率 98%,而且它點對了生成器:Suno 91%,ElevenLabs 以 7% 遠遠排在第二。關於這個檔案從哪來,我們什麼都沒告訴它。
第二首是 Rick Astley 的 Never Gonna Give You Up,錄於 1987 年——比這些模型裡的任何一個都早了幾十年。我們貼上了官方 YouTube 連結:
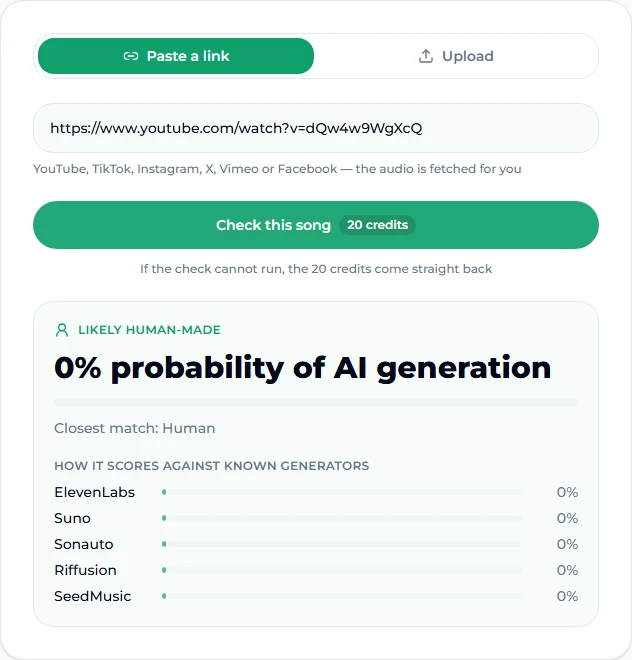
0%,最接近 Human,每個生成器都是零。兩個清楚的輸入,兩個清楚的答案——在你把不清楚的情況交給一個工具之前,先看到的應該就是這個。
怎麼看結果
結果卡片有四個部分:
- 結論——很可能是 AI 生成或很可能是人做的。「很可能」這幾個字是刻意的。
- 機率——模型有多大把握認為這首歌是生成的。
- 最接近——它最像的那個生成器,或 Human。
- 與各家生成器的相似度——「最接近」背後的細項。一根佔絕對優勢的長條(例如上面 Suno 的 91%)比好幾根不上不下的長條訊號更強。
一個實用的規則:高於大約 90%,判斷就站得住。低於大約 10%,可以當作真人作品。介於兩者之間,結果只是一種傾向,而不是結論。
數字落在中間的時候
中段的分數不代表工具失靈了。它通常代表這首歌確實是混合的,或被處理過:
- 重度母帶處理或重新編碼會把模型要聽的痕跡弄模糊。
- 透過喇叭重新錄製——有人放一首 AI 歌再用手機拍下來——會在上面再疊一層房間和麥克風。
- 混合作品是真實存在的:一個取樣了 AI 分軌的真人製作人,或一個在生成伴奏上錄了人聲的歌手,都會得到一個中間的分數,因為兩件事都是真的。
接下來怎麼做:換一段 30 秒再偵測(副歌和主歌的分數可能不同),盡量找你能找到最高品質的來源,而不是二次上傳的版本,再把結果和上面那些情境線索放在一起權衡。把任何偵測器——包括這一個——當作證據,而不是定論。
如果你是在把自己的音樂投到某處之前做檢查,反過來也一樣:你用 AI 音樂生成器做的歌會被讀成 AI,這沒關係,只要平台要求時你如實聲明就行。我們的能不能把 AI 音樂上傳到 Spotify 指南講了主要發行商想知道什麼。
常見問題
光靠聽真的能分辨一首歌是不是 AI 嗎?
有時候能。糊掉的銅鈸、不換氣的人聲和泛泛的歌詞都是真實的破綻,偷懶生成的歌通常會有好幾條。但用當前模型精心做出來的歌,往往一條你都聽不出來,這就是偵測器存在的原因。
AI 音樂偵測器有多準?
沒有哪個偵測器是百分之百確定的。在乾淨的輸入上,判斷很清楚——我們的 Suno 歌拿了 98%,1987 年的錄音拿了 0%。在中間的區間裡,結果只是一種傾向。後製處理、重新錄製和混合製作都會讓數字移動。
多少錢?
每次偵測 20 點數。點數來自任何方案或點數包。跑不起來的偵測會自動退點。
它能認出哪些生成器?
它用各大生成器——Suno、Udio、Mureka、ElevenLabs 等——的輸出訓練,結果會列出這首歌比對過的那些,例如 Lyria、SeedMusic、Sonauto 和 Riffusion。
能偵測 Spotify 上的歌嗎?
偵測器接受 YouTube、TikTok、Instagram、X、Vimeo 和 Facebook 的連結。只在 Spotify 上有的歌,就去 YouTube 上找同一首,或上傳檔案。
我的檔案會怎樣?
它只會為這一次偵測送到分析服務。網站保存的是結論,不是音訊。貼上的連結由服務直接抓取。
分數高是不是代表這首歌違反了什麼規定?
不是。它只說明這段音訊很可能是怎麼做出來的。這重不重要,取決於這首歌要去哪裡——比賽、發行商、授權——以及他們要求你聲明什麼。
結語
先從耳朵和情境開始:糊掉的高頻、從不換氣的嗓音、沒有任何具體細節的歌詞、毫無過往的藝人,都值得留意。當答案真的要緊時,拿一個數字。把連結貼進或把 30 秒上傳到 AI 音樂偵測,把結論和各生成器的分數放在一起看,介於 10% 和 90% 之間的任何結果,都當作需要再仔細看看的理由,而不是結論。