要点
如果人声背后在放音乐——咖啡馆的音箱、手机视频底下的一首歌、录播客时忘了关的曲子——你不需要原始工程文件也能把人声找回来。把文件上传到背景音乐去除(人声清理和人声分离用的也是同一个引擎),AI 分离会返回两条音轨:单独的人声,和单独的音乐。它接受 MP3、WAV、M4A 或 MP4 里的音频,最大 10 MB;一次分离花 10 积分,通常一到三分钟完成。然后把人声载入免费的均衡器,套用播客或人声预设,导出 MP3 或 WAV。一个老实话:分离去掉的是音乐。它不是用来去除底噪、风声或车流声的降噪器。
本文目录
分离能做什么、不能做什么
老式的"人声提取"技巧靠的是相位抵消:用右声道减去左声道,指望人声在正中间。它毁掉人声的次数和去掉音乐的次数差不多。现代的分离不一样。一个用成千上万条单独人声和伴奏训练出来的神经网络,会听完整段混音,然后重建出两个新文件——一个只有人声,一个是其余所有东西。因为它是在模拟人声听起来是什么样,而不是看它在立体声场里待在哪儿,所以单声道的手机录音也一样能处理。
它擅长的:
- 压在说话声下面的音乐。 vlog 背景里的一首歌、语音备忘录底下的咖啡馆音箱、渗进采访里的 DJ 串烧。
- 跟着伴奏的演唱。 一段排练视频,你想要单独的歌声。
- 两半都留着。 你还会拿到单独一条音乐音轨,如果你想把它换成自己有版权的音乐,这很方便。
它不是:
- 降噪器。 底噪、嗡声、风声、车流声和房间回声都不是音乐,模型也不会去处理它们。正因为如此,人声清理页面上明明白白写着这一点。
- 能把被埋掉的人声变出来的魔法。 如果音乐比说话的人响得多,分离出来的人声能用,但会更单薄。原始录音里人声越响,结果越干净。
开始之前
- 格式和大小。 MP3、WAV、M4A,或者 MP4 视频(会从中提取音频),最大 10 MB。一个 128 kbps 的 10 MB MP3 大约十分钟;文件更大的话,先把你需要的部分剪出来。
- 账号和积分。 分离在我们的服务器上运行,所以需要登录。每次运行花 10 积分;新账号送 16 个免费积分,够一次分离。更多积分来自任意套餐或积分包。
- 你的文件不会被保留。 上传的文件只用于那一次分离,任务结束后就会删除。
- 权利。 分离一段录音并不改变它归谁所有。从你自己的录音里分出的分轨归你;从别人的商业歌曲里分出来的分轨只供个人使用。
第一步 把人声和音乐分开
- 打开背景音乐去除。它默认在上传文件标签;另一个标签从我的曲库选是给你在本站生成的歌用的。
- 点虚线框,选你的录音。文件名会出现在框里。
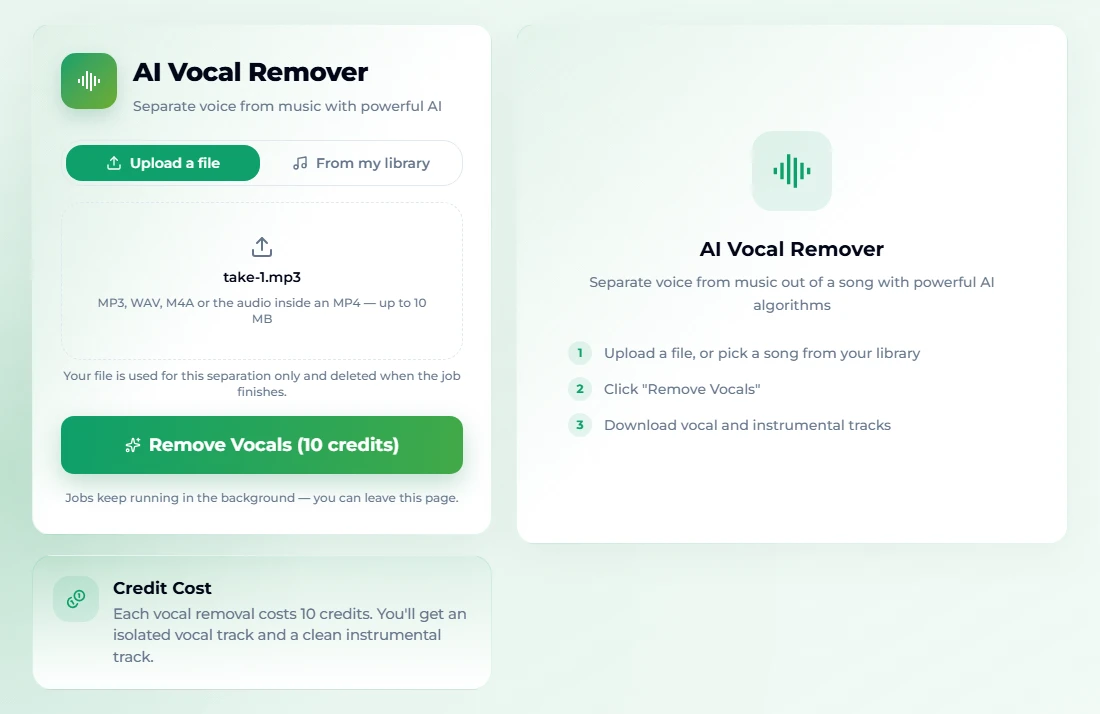
- 点去除人声(10 积分)。如果你还没登录,会先弹出登录窗口;任务真正开始之前不会扣任何积分。
- 任务在后台运行——根据长度通常一到三分钟——你可以离开页面。它会出现在右侧的任务列表里。
- 完成之后你会得到两个文件:单独的人声(清唱)和去掉人声的音乐(伴奏)。两个都听一听,然后下载人声。
按钮上写"去除人声",是因为同一个工具也会反过来用——把歌手从一首歌里拿掉做 K 歌伴奏。对一段人声录音来说,你要的是人声那个文件。如果分离失败,积分会自动退回。
第二步 用均衡器修饰人声
分离出来的人声常常有点闷或者有点轰:模型去掉了音乐,却保留了麦克风收到的每一点低频隆隆声。用均衡器花两分钟,大部分问题都能解决。
- 打开均衡器,点选一个音频文件载入分离出的人声。
- 选一个预设。说话的录音先从播客开始:它把最低的几个频段大幅衰减(31 Hz −8 dB,62 Hz −6),中间保持不动,并把 1–2 kHz 附近的临场感频段提升 3 dB,辅音和清晰度就在那里。
- 点播放,边听边微调单个滑块。十个频段——31、62、125、250、500 Hz 以及 1、2、4、8、16 kHz——每个都能动 ±12 dB,拖动时就能听到变化。
- 用下载 MP3或下载 WAV导出。导出走的是和预览同一条滤波链,所以文件听起来和你刚才听到的一模一样。
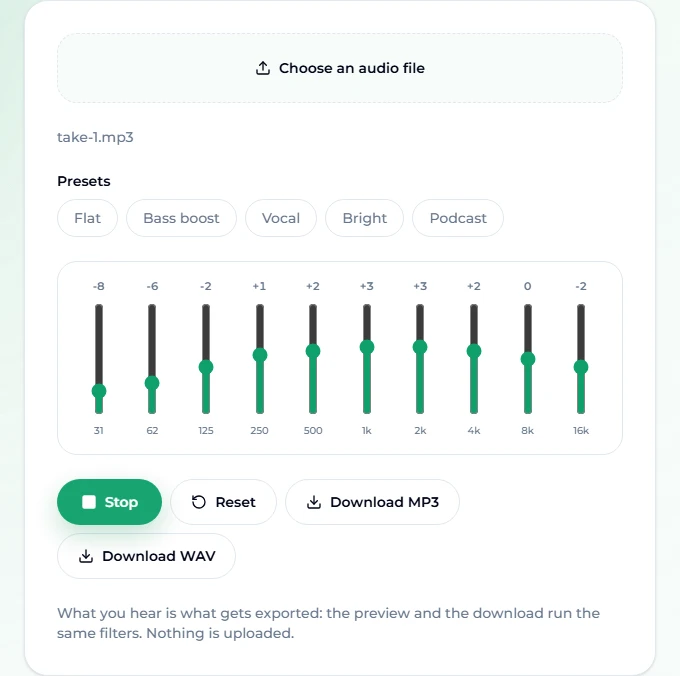
我们把测试文件导出为 WAV 时,得到的是一个完整长度、41 MB、文件名带 -eq 后缀的文件,可以直接拿进剪辑软件。均衡器从不上传任何东西——文件在你的浏览器里处理——免费,不用账号。
什么录音用什么预设
五个预设只是起点,不是定论:
| 录音 | 先用 | 再试 |
|---|---|---|
| 说话的语音备忘录、采访、播客 | 播客 | 有底噪的话把 16 kHz 再往下拉 |
| 唱歌、说唱、之后要配乐的旁白 | 人声 | 在 4 kHz 加 +1 或 +2,多一点空气感 |
| 听起来发闷或很远的人声 | 明亮 | 把 250 Hz 衰减 2–3 dB,去掉箱子味 |
| 单薄的手机录音 | 先平直,再在 125–250 Hz 加 +2 | 31–62 Hz 保持衰减,避免隆隆声 |
| 任何你处理过头的东西 | 归零 | 从平直重新开始 |
有一条规则比任何预设都管用:先减后加。每个频段都提升,只不过是把整个文件开大直到削波。把碍事的东西去掉——底部的隆隆声、250–500 Hz 附近的箱子味——通常比加高音更能让声音清楚。
故障排查
"这个文件超过 10 MB。" 把你需要的部分剪出来,或者用更低的码率导出。96 kbps 的 MP3 对说话来说完全够用,10 MB 能装下大约 14 分钟。
人声里有水汪汪、打旋的痕迹。 这发生在音乐和人声在同样的频率、差不多的音量上互相争抢的地方。试着分离一个只在说话处开始和结束的副本,让模型总体上听到的音乐更少。在均衡器里把 4–8 kHz 附近轻轻衰减一点,也能让这些痕迹柔和一些。
音乐没了,但还有底噪或车流声。 分离去掉的是音乐,不是噪音。用均衡器把两端削掉(低切去隆隆声,在 8–16 kHz 稍微衰减去底噪),噪音严重的话用专门的降噪工具。
均衡器说文件解不开。 用 MP3、WAV 或 M4A。视频文件里有些不常见的编码浏览器解不了;先转成 MP3。
导出失败了。 很长的文件可能会耗尽浏览器内存。把录音分成几段较短的,分别导出。
它能解决的真实场景
- 咖啡馆里的语音备忘录。 你用手机录了一个歌的点子,咖啡馆音箱正放着一首流行歌。分离一下,留下人声,拿它当参考人声。
- 演讲视频。 一段乐队演奏时拍下的婚礼致辞。分离出的人声套上播客预设,清楚到足够剪进精彩集锦。
- 渗了音乐的播客录音。 有人在采访时让歌单一直放着。分离能救回这条录音,不用重录。
- 把 vlog 里有版权的音乐换掉。 分离,留下人声,底下垫一首你有权使用的曲子——比如你自己在 AI 音乐生成器上生成的。我们的 YouTube 用的 AI 音乐指南讲了平台会标记什么。
- 跟着伴奏唱的录音。 留下人声做翻唱,或者留下伴奏用来练习。如果目标是 K 歌,伴奏版指南讲的是这个方向。
常见问题
去掉录音里的背景音乐免费吗?
均衡器那一步免费,不用账号。分离那一步在我们的服务器上用 AI 运行,每次花 10 积分;新账号送 16 个免费积分,够一次分离。
能上传哪些文件?
MP3、WAV、M4A,或者 MP4 视频(使用其中的音轨),每个文件最大 10 MB。
音乐也能拿回来吗?
能。每次分离都会返回两个文件:单独的人声,和去掉人声的音乐。两个都能在任务列表里播放和下载。
它能去掉风声、底噪或车流声吗?
不能。分离是为把人声和音乐分开而做的。它不针对噪音,人声清理页面上也写明了这一点。均衡器可以让底噪和隆隆声柔和一些;严重的噪音需要降噪工具。
要多久?
大多数录音一到三分钟完成,取决于长度。任务在后台运行,所以你可以离开页面再回来。
我的录音会被保存吗?
上传的文件只用于那一次分离,任务结束后就会删除。均衡器则根本不上传任何东西。
清理后的人声能商用吗?
如果是你自己的录音,可以。分离一段录音不会改变它的所有权,所以从别人的商业歌曲里分出来的分轨仍然只供个人使用。
写在最后
一段被背景音乐毁掉的好录音,是音频里最能修好的问题之一。用背景音乐去除把它分成人声和音乐两个文件,再在均衡器里用播客或人声预设花两分钟,然后导出。期望要实事求是——它抽掉的是音乐,不是风声或底噪——大多数咖啡馆备忘录、拍下来的演讲和被打断的播客录音都能救回来用。