要点
大多数 AI 歌曲都对了 90%。副歌到位,编曲不错,只有某段主歌里有一句被模型听错了,或者是你后来改过的词。重新生成会把那 90% 一起扔掉。Suno AI Music 上的替换片段把它们留下:选中曲子,标出要重做的那一段(6 到 60 秒之间),输入应该唱的歌词,模型就会以原曲为上下文,用同样的嗓音、调性和编曲把这一段重新唱一遍。10 积分,两个版本,曲子其余部分不动。范围越紧、边缘越干净,接缝就越听不出来。
本文目录
替换片段在做什么
它重剪一首完成的歌里的一部分。你标出一个时间范围;给它这里该唱的词;它用同一个模型、以周围的音频为上下文,为这个范围生成一次新的演绎,所以新的部分会以同样的调性、速度、嗓音和编曲进来,并在范围结尾交还给原曲。范围之外的一切都不动:你已经拥有的音频,既不用为它付钱,也不用为它冒险。
三个约束定义了它:
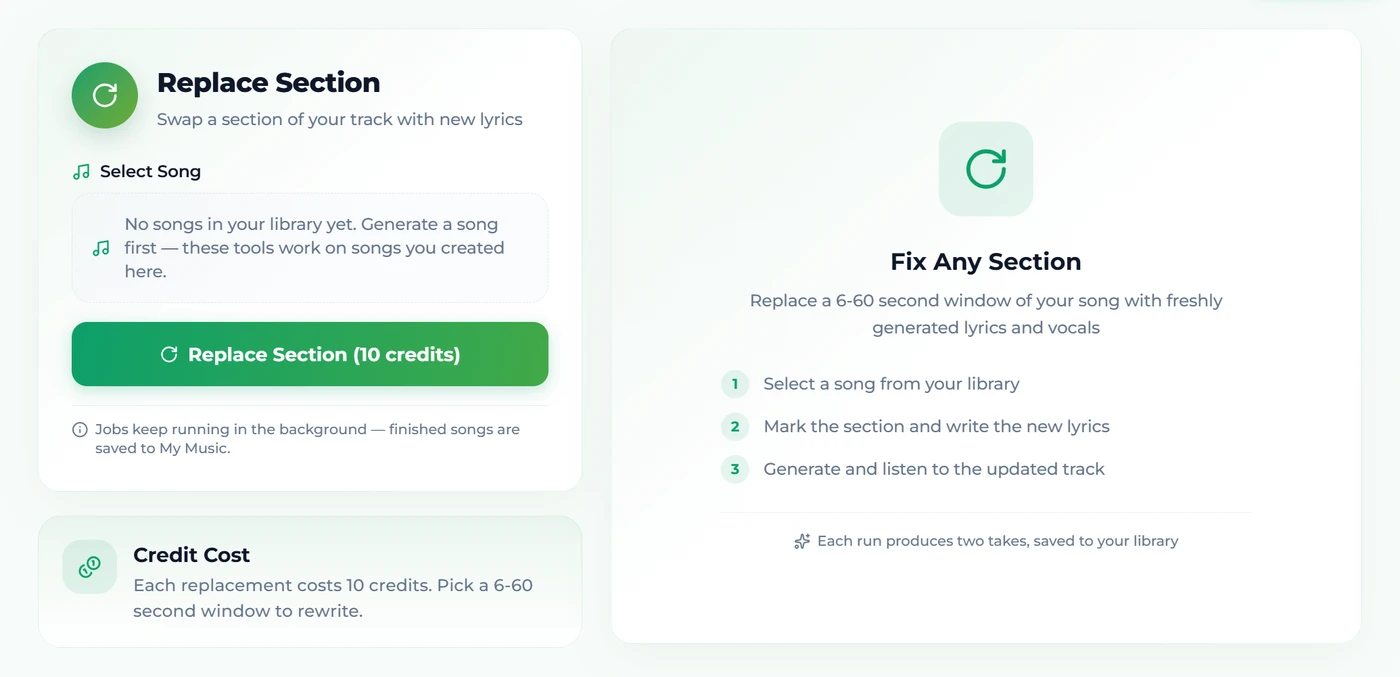
- 6 到 60 秒。 短于六秒,模型没有足够的上下文把接缝融合起来;长于一分钟,你最好去延长或重新生成。
- 你自己的曲库。 和其他工具一样,它读取你的歌(生成的、翻唱的、延长的),而不是接受上传。
- 10 积分,两个版本。 和一次完整生成的价格相同,也是同样的双版本习惯:两个都试听,留下接得更好的那个。积分来自注册送的 16 个,或者任何套餐或积分包。
替换 延长还是翻唱
三个编辑工具解决的是不同的问题,选错了就浪费积分:
| 问题 | 工具 | 为什么 |
|---|---|---|
| 一句错了,其余都对 | 替换片段 | 只重唱这一段;歌还是那首歌 |
| 歌结束得太早 | 延长 | 从某一点继续;增加长度,而不是改动已有的部分 |
| 编曲或曲风不对 | 翻唱 | 用新风格重新演绎整首歌;旋律和歌词不变 |
| 人声对了,但你需要伴奏 | 人声分离 | 分离,而不是重新生成 |
| 整首都不对 | 重新生成 | 改提示词里的一个词再跑一次 |
经验法则:如果你能指出错的是哪几秒,就替换。指不出来,问题就比一个片段大。
分步操作
- 打开替换片段工具,从你的曲库里选歌。
- 播放它,记下要重做那部分的起点和终点,以秒为单位。让边缘尽量落在乐句的边界上(见下一节)。
- 设定范围。必须在 6 到 60 秒之间。
- 输入替换歌词:这个范围里应该唱的词,只写这些。
- 点替换片段(10 积分)。任务在后台运行;一到三分钟后两个版本到达,每个都是替换好新片段的整首歌。
- 戴上耳机、开大音量听两个接缝。留下你听不出接缝的那个;如果两个都听得出来,调整范围(通常是把它扩到最近的乐句边界),再跑一次。
选择范围
你要处理的是接缝,而范围决定了接缝。
- 在乐句边界上切。 从一句开始的地方开始,在一句结束的地方结束。在一个字或一个音中间切,就是大家听到的接缝。
- 优先整句或整段。 替换"第二段主歌的第二句"是可以的,但模型要匹配的东西更多;替换"第二段主歌"则给了它自然的进出口。
- 两边各留一口气。 如果错的那句在 0:41–0:47,就标 0:40–0:48,让模型重新生成进来时的吸气和出去时的收尾,因为拼接恰恰会在那里露馅。
- 控制在一分钟以内。 超过这个长度,模型实际上是在写一个新段落,编曲可能会漂移。
- 纯器乐段也行。 标出一段你不喜欢的独奏,歌词栏留空替换它;模型会在上下文里演奏一段新的独奏。
写替换歌词
歌词栏就是全部的指令;替换没有风格框,因为风格就是这首歌。
- 字数尽量和原句对齐。 旋律是被重新演唱的;字数多一倍的句子会被硬塞进去,少一半的会被拉长。
- 如果前后句和它押韵,就保留那个韵,或者把范围扩大,把它们全都改掉。
- 范围内的结构标签是可选的,但如果范围跨过一个段落边界,在顶部写一行
[Chorus]或[Verse]能帮模型读懂能量。每个标签的作用见标签指南。 - 只写这个范围的词。 把整首歌的歌词贴进来,等于要求模型把它们全塞进 20 秒里。
接缝还是听得出来时
两个版本加上一个干净的范围,通常就能解决问题。如果接缝还是听得出来,原因几乎总是下面五个之一,每个都只需要多跑一次,而不是做一首新歌:
- 切点落在乐句中间。 最常见的一种。把范围两边都扩到最近的静音处(句子开始前一拍、句子落定后一拍),再跑一次。从一口气开始的范围,比从一个音节开始的藏得更好。
- 字数变了。 替换句明显比原句长或短,会逼着模型重新安排旋律的时值,你听到的是这个重排,而不是拼接。数一数原句的字数,差距控制在一两个字以内。
- 范围跨过了段落边界。 半段主歌加半段副歌,等于要求模型复刻一个不是它写的过渡。要么待在一个段落里,要么两个段落整个都拿。
- 能量跳了。 如果被替换的部分处在一段推进之下,在歌词顶部加上结构标签(
[Chorus]、[Bridge]),让模型读出预期的强度,而不是去猜。 - 范围太短。 六七秒几乎没有足够的上下文去匹配。如果错的词只占四秒,就把它周围的整句都替换掉。
如果第三次还是听得出接缝,问题通常不在范围上:你要修的这一段承载着编曲其余部分所依赖的东西,这时用同样的风格把整首歌翻唱一遍,是更便宜的出路。
它最擅长的修补
替换片段胜过所有其他办法的地方:
- 听错的那句。 模型把"a light in the hall"唱成了"a light in the hole"。输入正确的词,标出那一句,搞定。
- 听过之后你改写的词。 歌一旦存在就会变好;一段读着好、唱着差的主歌,不用做新歌就能换上一句更好的。
- 名字、日期、地点。 一首给婚礼、品牌或生日的歌:唱出来的某个细节要改,别的都不该动。
- 弱的桥段。 标出桥段,重写它,保留大家已经喜欢的副歌。
- 为公开发布清理一句。 客户视频里,某个你宁愿不被唱出来的词。
- 换一段独奏。 歌词栏留空,标出独奏,得到一段依然属于这首曲子的新独奏。
它不适合做的:改变曲风(用翻唱)、加长(用延长),或者修一首从头到尾都不对的歌(重新生成,并且先改提示词里的一个词)。
常见问题
替换的片段能有多长?
6 到 60 秒之间。更短的话,模型的上下文太少,接缝融不好;更长的话,是延长或新生成的活。
新片段和歌的其余部分搭吗?
它以原曲为上下文、用同一个模型生成,所以调性、嗓音和编曲都一致。范围紧、落在乐句边界上,接缝最难被听出来。
能用这个办法修正错的或听错的歌词吗?
能,这正是它的主要用途。按应有的样子输入那一句,标出它占的那几秒,模型就会重唱这一段。
要多少钱?
10 积分,和一次完整生成一样,你会拿到两个版本。曲子其余部分不动。
能编辑哪些歌?
你自己曲库里的任何一首:生成的、翻唱的、延长的或之前编辑过的。不能上传。
能替换纯器乐的部分吗?
能。标出范围,歌词留空;模型会在上下文里演奏一段新的乐段。
写在最后
指出错的是哪几秒,给模型这里该唱的词,其余一切保留。替换片段就是那个花 10 积分、把一首对了 90% 的歌变成成品的工具:在乐句边界上切,字数对齐,两个版本都试听,接缝就消失了。